Co to jest robots.txt? Definicja, składnia i przykłady
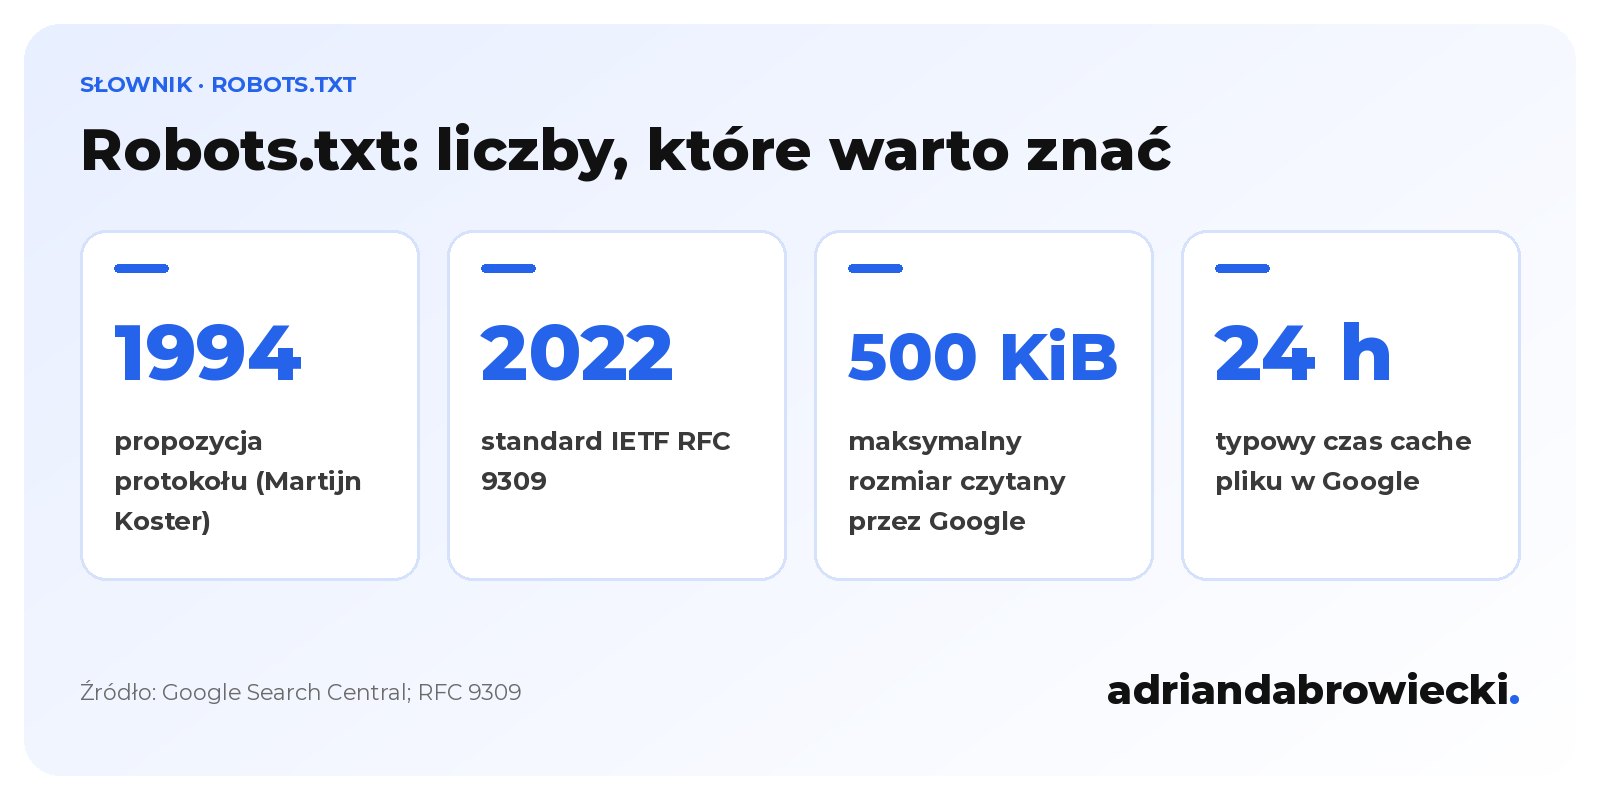
Robots.txt to plik tekstowy umieszczony w katalogu głównym hosta, który informuje roboty wyszukiwarek, które adresy URL mogą pobierać, a których nie powinny. Protokół zaproponował Martijn Koster w 1994 roku, a IETF opublikował go jako standard RFC 9309 we wrześniu 2022 roku.
Do czego służy robots.txt
Robots.txt to pierwszy plik, który uczciwy robot pobiera z serwera, zanim zażąda jakiegokolwiek innego adresu. Zawiera reguły, które mówią, gdzie robot może wejść, a gdzie nie powinien. Google wskazuje jako główny cel ochronę serwera przed nadmiarem zapytań i kierowanie robotów do ważnych części serwisu.
Dwie rzeczy, które tłumaczę klientom najczęściej. Po pierwsze przestrzeganie pliku jest dobrowolne: Googlebot i Bingbot go respektują, ale scrapery już niekoniecznie, więc nie jest to zabezpieczenie. Po drugie plik steruje crawlowaniem, a nie indeksowaniem. Zablokowany adres może trafić do Google, jeśli linkują do niego inne strony, zwykle bez opisu. Żeby usunąć stronę z wyników, potrzebny jest noindex, a robot musi mieć do niej dostęp, żeby ten tag zobaczyć.
Składnia robots.txt krok po kroku
Robots.txt składa się z grup. Każda zaczyna się od linii User-agent, czyli nazwy robota, po której następują reguły Allow i Disallow. Google obsługuje cztery pola: user-agent, allow, disallow i sitemap. Przykładowy plik sklepu internetowego może wyglądać tak:
User-agent: *Disallow: /koszyk/Disallow: /*?sortuj=Allow: /koszyk/pomoc/Sitemap: https://example.pl/sitemap.xml
Gwiazdka oznacza dowolny ciąg znaków, a znak dolara koniec adresu. Wielkość liter w ścieżkach ma znaczenie, więc /Koszyk/ i /koszyk/ to dwa różne adresy. Przy konflikcie reguł Google wybiera najbardziej szczegółową, czyli tę z najdłuższą pasującą ścieżką, a przy remisie mniej restrykcyjną. Dlatego w przykładzie powyżej strona /koszyk/pomoc/ pozostaje dostępna mimo blokady całego koszyka.
Jak Google czyta robots.txt
Robots.txt musi leżeć w katalogu głównym, np. https://example.pl/robots.txt, i działa tylko dla tego samego protokołu, hosta i portu. Google czyta do 500 KiB pliku i zwykle trzyma go w pamięci podręcznej do 24 godzin, więc zmiany nie działają natychmiast.
| Sytuacja | Co robi Google |
|---|---|
| Plik zwraca 4xx (poza 429) | traktuje witrynę jak bez ograniczeń |
| Plik zwraca 5xx | wstrzymuje crawlowanie na 12 godzin, potem do 30 dni korzysta z ostatniej wersji |
| Przekierowania pliku | podąża za maksymalnie 5 |
| crawl-delay, nofollow, noindex | ignoruje (noindex w robots.txt od 1 września 2019) |
Bing obsługuje crawl-delay jako względne spowolnienie, więc przy serwerze, który nie wytrzymuje ruchu robotów, ta dyrektywa pomoże tylko częściowo. Dla Google tempo crawlowania reguluje sam serwer, np. odpowiadając kodem 429 albo 503.
Robots.txt w praktyce SEO
Robots.txt to dla mnie narzędzie do oszczędzania crawl budgetu na stronach, które nie powinny pochłaniać uwagi robotów. W dużych sklepach na PrestaShopie, Magento czy WooCommerce blokuję zwykle wyniki wyszukiwarki wewnętrznej, niekończące się kombinacje filtrów i sortowania oraz koszyk. Czego nie blokuję nigdy: plików CSS i JavaScript potrzebnych do renderowania strony. Bez nich Google widzi inną stronę niż użytkownik.
Najczęstsze błędy, które znajduję w audytach w ramach technicznego SEO:
Disallow: /zostawione po etapie testów na serwerze produkcyjnym,- blokada katalogu z obrazami produktów, przez którą znikają one z Grafiki Google,
- blokada stron, które mają noindex, przez co Google nigdy go nie odczyta,
- brak linii Sitemap albo adres starej mapy witryny XML.
Pamiętaj też, że każda subdomena i każda wersja krajowa potrzebuje własnego pliku. Blokada katalogu /de/ zostawiona po wdrożeniu nowego języka potrafi po cichu wyłączyć z Google cały rynek, a zablokowane wersje językowe psują też zestawy hreflang.
Robots.txt a roboty AI
Robots.txt służy dziś także do sterowania robotami firm AI. Google udostępnia token Google-Extended, który decyduje, czy treści mogą być używane do trenowania modeli Gemini i ugruntowania odpowiedzi w aplikacjach Gemini i Vertex AI. Według Google nie wpływa on na obecność ani pozycje w wyszukiwarce. Inne roboty AI, np. GPTBot, ClaudeBot czy PerplexityBot, przedstawiają się własnymi nazwami, więc każdego można dopuścić albo zablokować w osobnej grupie.
Klientom radzę rozdzielić dwie decyzje: zgodę na trenowanie modeli i zgodę na pojawianie się w odpowiedziach AI. Blokada robotów wyszukujących oznacza zwykle utratę cytowań w danym asystencie, a to coraz ważniejsze źródło ruchu. Listę robotów AI przeglądam co kilka miesięcy, bo firmy regularnie dodają nowe nazwy i zmieniają zasady działania istniejących.
Disallow: / dla wszystkich robotów. Pięć minut pracy chroni przed jednym z najdroższych jednolinijkowych błędów w SEO.robots.txt: najczęstsze pytania
Krótkie odpowiedzi na pytania, które często słyszę o tym, czym jest robots.txt i jak z tego korzystać.
Czy robots.txt usuwa stronę z Google?
Nie. Plik blokuje pobieranie strony, ale adres nadal może pojawić się w wynikach, jeśli linkują do niego inne witryny. Do usunięcia strony z indeksu służy noindex albo kod 404 lub 410.
Co się stanie, jeśli nie mam pliku robots.txt?
Gdy plik nie istnieje i serwer zwraca 404, Google uznaje, że może pobierać całą witrynę. Dla małej strony to zwykle w porządku, ale plik warto mieć choćby po to, żeby wskazać mapę witryny.
Jak sprawdzić, czy robots.txt działa poprawnie?
W Google Search Console znajdziesz raport robots.txt z ostatnią pobraną wersją i ewentualnymi błędami. Pojedyncze adresy sprawdzisz narzędziem do sprawdzania adresu URL.
Czy zablokować roboty AI w robots.txt?
To zależy od celu. Blokada robotów trenujących chroni treści przed użyciem w modelach, ale blokada robotów wyszukujących usuwa stronę z odpowiedzi asystentów AI.
robots.txt: powiązane pojęcia
Pojęcia, które warto znać razem z hasłem robots.txt.
- Introduction to robots.txt · Google Search Central
- How Google interprets the robots.txt specification · Google Search Central
- RFC 9309: Robots Exclusion Protocol · IETF / RFC Editor
- A note on unsupported rules in robots.txt · Google Webmaster Central Blog
- Overview of Google crawlers and fetchers (Google-Extended) · Google Search Central