Co to jest crawl budget? Definicja, czynniki i optymalizacja
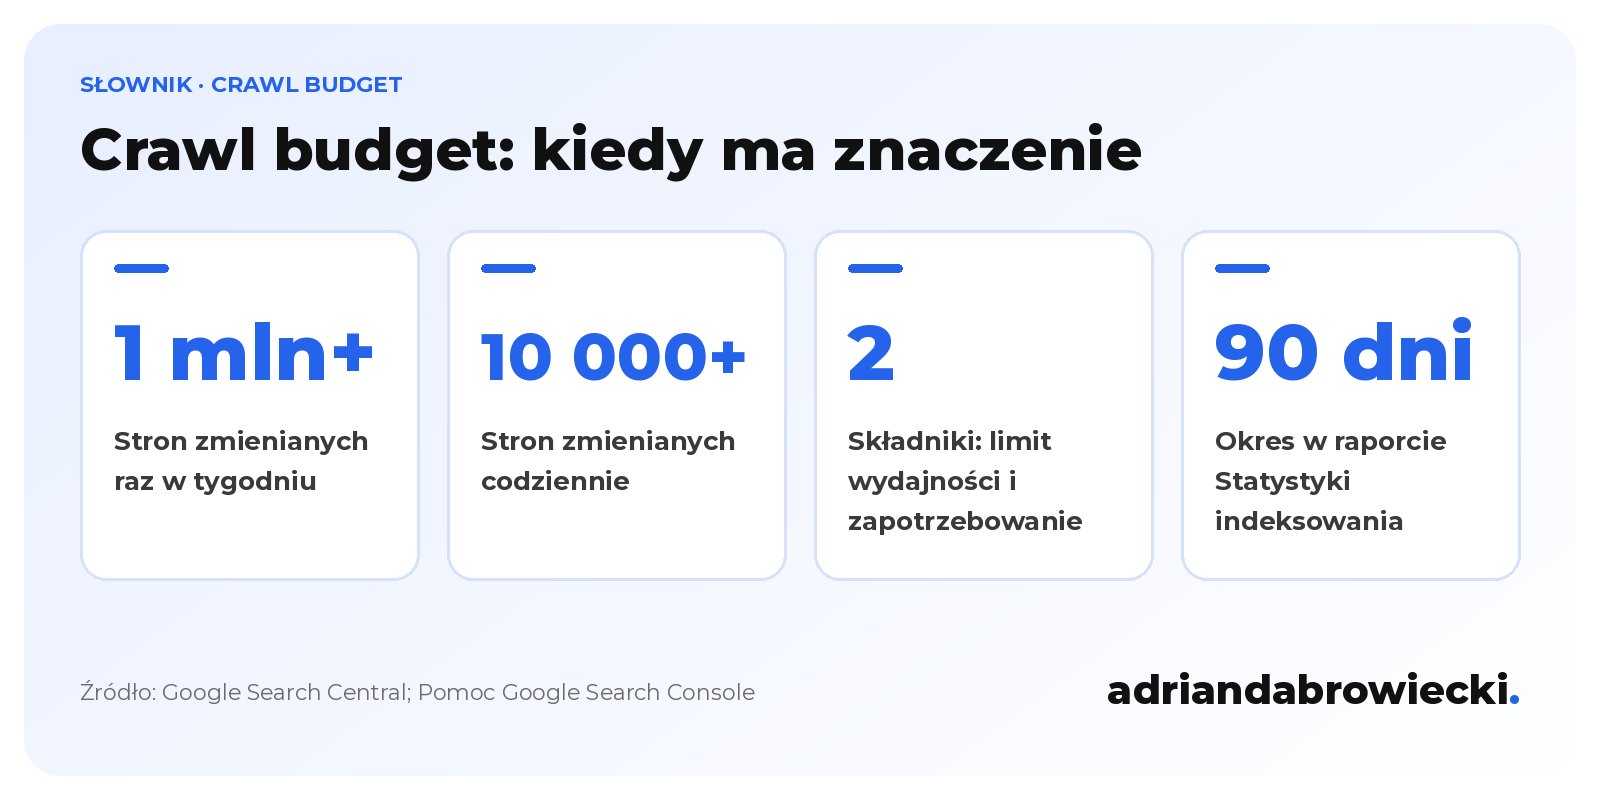
Crawl budget to liczba adresów URL w serwisie, które Googlebot jest w stanie i ma ochotę przeskanować w określonym czasie, nazywana po polsku budżetem indeksowania. Według dokumentacji Google Search Central temat realnie dotyczy serwisów z ponad milionem stron zmienianych co tydzień albo ponad 10 000 stron aktualizowanych codziennie. W audytach sklepów widzę jednak, że filtry i parametry potrafią wpędzić w ten problem także średniej wielkości serwis.
Czym jest crawl budget?
Crawl budget to czas i zasoby, które roboty Google przeznaczają na jedną nazwę hosta. Słowo „host” jest tu ważne: sklep.pl i blog.sklep.pl to dla Google dwa osobne serwisy z osobnymi budżetami. Jeśli wartościowych adresów jest więcej, niż robot zdąży odwiedzić, nowe produkty i zaktualizowane artykuły czekają w kolejce. Skutek widać jako opóźnione indeksowanie i wolniejszą reakcję pozycji na zmiany. Bing i inne wyszukiwarki mają podobne ograniczenia, ale samo pojęcie jest kojarzone głównie z Google.
Od czego zależy crawl budget?
Crawl budget wynika z dwóch sił: tego, ile wytrzyma serwer, i tego, ile Google chce pobrać. Dokumentacja Search Central opisuje je osobno.
Limit wydajności skanowania
To górna granica liczby równoległych połączeń i tempa pobierania, z jakim Googlebot odwiedza serwer. Gdy strona odpowiada szybko, limit rośnie. Gdy serwer zwalnia, zwraca błędy 5xx albo kod 429, Google zwalnia razem z nim. Limit jest wspólny dla wszystkich robotów Google, również tych od grafik i reklam.
Zapotrzebowanie na skanowanie
Google decyduje, jak często wracać, na podstawie trzech czynników: liczby znanych mu adresów (łącznie z duplikatami), popularności adresów w sieci oraz tego, jak często treść się zmienia. Migracja domeny lub zmiana struktury URL-i chwilowo zwiększa zapotrzebowanie, bo robot musi poznać nowe adresy.
Kogo naprawdę dotyczy crawl budget?
Crawl budget jest problemem głównie dużych lub bardzo dynamicznych serwisów. Google podaje orientacyjne progi:
| Rodzaj serwisu | Kiedy budżet ma znaczenie |
|---|---|
| Bardzo duży | ponad 1 000 000 unikalnych stron zmienianych mniej więcej raz w tygodniu |
| Średni lub duży, dynamiczny | ponad 10 000 unikalnych stron zmienianych codziennie |
| Z lukami w indeksie | wiele adresów ze statusem „Strona wykryta – obecnie nie zindeksowana” |
Mały blog firmowy, którego wpisy pojawiają się w Google w dniu publikacji, może spokojnie odpuścić ten temat. Inaczej jest w e-commerce: nawigacja fasetowa z filtrami koloru, rozmiaru i ceny potrafi zamienić katalog 20 000 produktów w miliony kombinacji URL-i, a do tego dochodzą wersje językowe opisane w hreflang.
Jak optymalizuję crawl budget u klientów
Optymalizacja crawl budgetu to w mojej praktyce głównie sprzątanie adresów, a dopiero potem przyspieszanie serwera. Kolejność działań, którą stosuję w ramach technicznego SEO:
- Wyłączam ze skanowania w robots.txt bezwartościowe kombinacje filtrów i parametrów sortowania.
- Scalam zduplikowane treści i porządkuję tagi canonical.
- Usuwane na stałe strony zwracają 404 lub 410, a błędy soft 404 znikają.
- Skracam łańcuchy przekierowań i zamieniam tymczasowe przekierowania na stałe tam, gdzie zmiana jest trwała.
- Aktualizuję mapę witryny XML z poprawnym lastmod.
- Na koniec poprawiam czas odpowiedzi serwera i obsługę kodu 304 Not Modified.
Dwa mity, które często słyszę: noindex nie oszczędza budżetu, bo robot musi pobrać stronę, żeby zobaczyć ten tag, a blokada w robots.txt nie przerzuca automatycznie budżetu na inne adresy, jeśli serwer nie był wcześniej wąskim gardłem.
Jak mierzyć crawl budget w Google Search Console
Crawl budget najłatwiej podejrzeć w raporcie „Statystyki indeksowania”, który znajdziesz w ustawieniach Google Search Console. Raport pokazuje liczbę żądań, ilość pobranych danych, średni czas odpowiedzi, rozkład kodów HTTP, cel skanowania i typ Googlebota oraz stan hosta z ostatnich 90 dni. Przy dużych serwisach łączę te dane z analizą logów serwera, bo dopiero logi pokazują, które sekcje robot odwiedza, a które pomija.
Na co patrzę w pierwszej kolejności? Na wzrost średniego czasu odpowiedzi, bo zwykle wyprzedza spadek liczby żądań. Na udział kodów 3xx i 4xx, który pokazuje, ile pracy robot marnuje na przekierowania i nieistniejące strony. Na proporcję skanowania „odświeżającego” do „wykrywającego”: jeśli publikujesz dużo nowych stron, a robot prawie wyłącznie odświeża stare, nowe adresy są słabo podlinkowane albo brakuje ich w mapie. Przy migracjach porównuję te wskaźniki tydzień do tygodnia, żeby szybko zauważyć, czy Google nadąża za nową strukturą.
Wolne skanowanie ma dziś jeszcze jeden skutek: AI Overviews i Google AI Mode korzystają z tego samego indeksu, więc strona, do której robot nie dotarł, nie trafi także do odpowiedzi generatywnych.
crawl budget: najczęstsze pytania
Krótkie odpowiedzi na pytania, które często słyszę o tym, czym jest crawl budget i jak z tego korzystać.
Czy crawl budget wpływa bezpośrednio na pozycje?
Nie, crawl budget nie jest czynnikiem rankingowym. Wpływa na to, jak szybko Google odkryje i odświeży stronę, więc pośrednio decyduje o tym, kiedy zmiany zaczną działać.
Skąd wiem, że mam problem z budżetem indeksowania?
Sygnałem ostrzegawczym jest duża liczba adresów ze statusem „Strona wykryta – obecnie nie zindeksowana” w Search Console oraz nowe strony, które czekają na wizytę robota tygodniami. Warto też sprawdzić w logach, ile żądań trafia w adresy z parametrami.
Czy szybszy hosting zwiększy crawl budget?
Może zwiększyć limit wydajności, bo Google przyspiesza skanowanie, gdy serwer odpowiada szybko i bez błędów. Nie pomoże jednak, jeśli robot marnuje czas na tysiące zbędnych URL-i.
Czy tag noindex oszczędza crawl budget?
Nie. Google musi pobrać stronę, żeby odczytać noindex, więc do ograniczania skanowania lepiej służy robots.txt albo całkowite usunięcie zbędnych adresów.
crawl budget: powiązane pojęcia
Pojęcia, które warto znać razem z hasłem crawl budget.
- Large site owner's guide to managing your crawl budget · Google Search Central
- Crawl Stats report · Google Search Console Help
- Managing crawling of faceted navigation URLs · Google Search Central