Co to jest duży model językowy (LLM)? Definicja i działanie
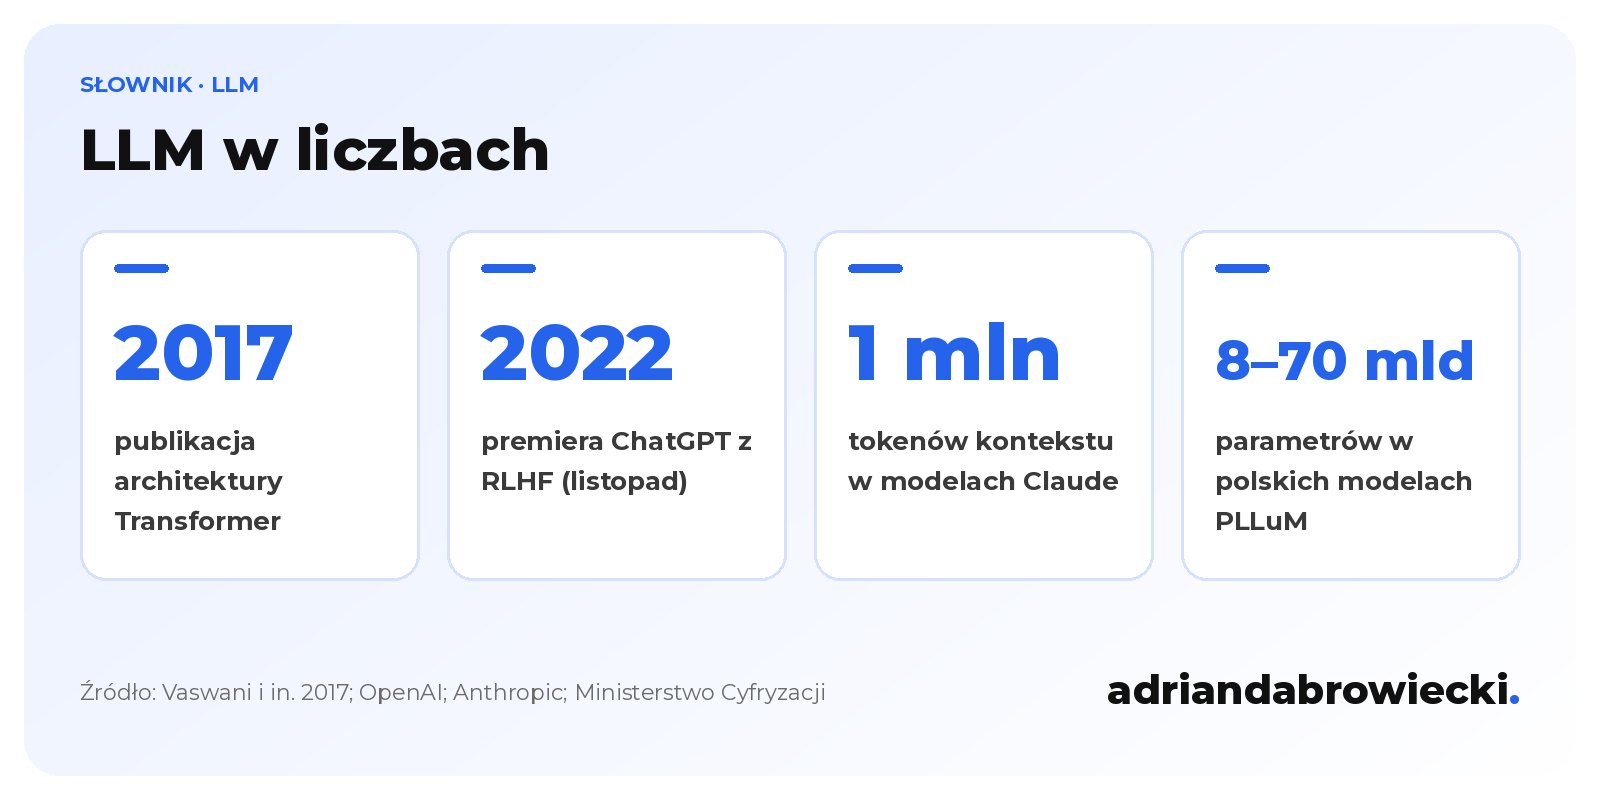
LLM (large language model, duży model językowy) to sieć neuronowa wytrenowana na ogromnych zbiorach tekstu, która przewiduje kolejny fragment wypowiedzi i dzięki temu pisze, streszcza oraz tłumaczy. Prawie wszystkie współczesne modele tego typu bazują na architekturze Transformer, opisanej przez badaczy Google w czerwcu 2017 roku.
LLM w jednym akapicie
LLM to w uproszczeniu bardzo rozbudowane autouzupełnianie. Model dostaje tekst, dzieli go na tokeny, czyli całe słowa, ich fragmenty albo pojedyncze znaki, a potem dla każdego możliwego kolejnego tokenu liczy prawdopodobieństwo. Wybiera jeden, dopisuje go do tekstu i powtarza ten krok setki razy, aż powstanie zdanie, akapit albo cała odpowiedź. Na tej zasadzie działają ChatGPT, Claude i Google Gemini.
Ciekawostka ważna dla polskich firm: polszczyzna, ze względu na bogatą odmianę, zużywa zwykle więcej tokenów na jedno słowo niż angielski. Przy pracy przez API przekłada się to na wyższy koszt tego samego tekstu. Druga rzecz, o której warto pamiętać: model nie „wie” niczego w ludzkim sensie. Odtwarza wzorce z danych treningowych, więc jego wiedza kończy się w dniu zamknięcia zbioru danych. Aktualne informacje, np. dzisiejsze ceny czy nowe przepisy, dostaje dopiero wtedy, gdy aplikacja pozwala mu przeszukać internet albo firmową bazę dokumentów.
Jak zbudowany jest LLM: Transformer
LLM korzysta dziś niemal zawsze z architektury Transformer, przedstawionej w pracy „Attention Is All You Need” (Ashish Vaswani i współautorzy z Google), opublikowanej w serwisie arXiv 12 czerwca 2017 roku. Jej sercem jest mechanizm samouwagi (self-attention): model ocenia, które słowa w zdaniu są ze sobą powiązane. Dzięki temu w zdaniu „Klient nie kupił laptopa, bo był za drogi” wie, że „był” dotyczy laptopa, a nie klienta.
Warto znać jeszcze trzy pojęcia:
- Parametry: wyuczone wagi sieci. Największe modele mają ich setki miliardów, a nawet biliony.
- Okno kontekstu: liczba tokenów, które model czyta naraz. Aktualne modele Claude przyjmują np. 1 mln tokenów.
- Embeddingi: liczbowe reprezentacje znaczenia tekstu, wykorzystywane także w wyszukiwarkach do dopasowania treści do zapytań.
Jak trenuje się LLM
LLM powstaje w kilku etapach. Każdy z nich dodaje coś innego: najpierw wiedzę o języku, potem umiejętność wykonywania poleceń, a na końcu dostęp do aktualnych faktów.
| Etap | Co się dzieje |
|---|---|
| Pretrening | Model uczy się przewidywać tokeny na gigantycznym zbiorze tekstów, co trwa miesiące. |
| Dostrajanie instrukcyjne | Model uczy się odpowiadać na polecenia na przykładach pytań i odpowiedzi. |
| RLHF | Ludzie oceniają odpowiedzi, a model nagrody koryguje zachowanie LLM. Tę metodę OpenAI zastosowało przy ChatGPT w listopadzie 2022 roku. |
| Wyszukiwanie i narzędzia | Gotowy model sięga do internetu lub bazy danych, żeby oprzeć odpowiedź na aktualnych źródłach. |
Ostatni etap jest dla mnie jako specjalisty SEO najważniejszy. To właśnie wtedy model wybiera strony, które przeczyta i zacytuje, a więc decyduje, czy Twoja marka pojawi się w odpowiedzi.
Polskie LLM: PLLuM i Bielik
LLM tworzone są także w Polsce. W lutym 2025 roku Ministerstwo Cyfryzacji udostępniło PLLuM, rodzinę modeli od 8 do 70 mld parametrów, zbudowaną przez konsorcjum 6 instytucji pod kierunkiem Politechniki Wrocławskiej. Równolegle rozwijany jest Bielik, otwarty model trenowany z myślą o języku polskim. Takie modele przydają się tam, gdzie liczy się naturalna polszczyzna, kontrola nad danymi i możliwość uruchomienia modelu na własnym serwerze, np. w administracji czy w firmach przetwarzających dane wrażliwe.
LLM a SEO i widoczność w AI
LLM zmienia SEO, bo pisze odpowiedź, zanim użytkownik zobaczy jakikolwiek link. AI Overviews w Google, ChatGPT z wyszukiwaniem czy Perplexity pobierają strony, tną je na krótkie fragmenty, streszczają i cytują tylko kilka źródeł. Optymalizację pod ten etap nazywa się Generative Engine Optimization i zajmuję się nią w ramach usługi GEO i AI SEO.
Z działania modeli wynikają trzy proste zasady, które stosuję w treściach klientów:
- Odpowiedź na pytanie z nagłówka umieszczam w pierwszym zdaniu sekcji, bo systemy wyszukiwania wycinają krótkie fragmenty.
- Encje nazywam wprost: firmę, produkt, miasto, a nie „nasze rozwiązanie” czy „tutaj”.
- Liczby podaję dokładnie i ze źródłem, bo model chętniej cytuje stwierdzenia, które da się zweryfikować.
Pamiętaj też, że modele mają ograniczenia. Potrafią tworzyć płynne, ale nieprawdziwe zdania, czyli halucynacje, przejmują uprzedzenia z danych treningowych i są kosztowne w trenowaniu. Dlatego każdą statystykę w tekście napisanym z pomocą AI sprawdzam w źródle przed publikacją.
LLM: najczęstsze pytania
Krótkie odpowiedzi na pytania, które często słyszę o tym, czym jest LLM i jak z tego korzystać.
Co to jest LLM w prostych słowach?
LLM to program AI, który na podstawie ogromnej ilości przeczytanych tekstów przewiduje, jakie słowo powinno pojawić się dalej. Dzięki temu potrafi odpowiadać na pytania, pisać i tłumaczyć.
Czy ChatGPT i LLM to to samo?
Nie do końca. LLM to sam model językowy, a ChatGPT to aplikacja, która korzysta z modeli GPT i dodaje do nich interfejs czatu, narzędzia oraz wyszukiwanie w sieci.
Skąd biorą się halucynacje modeli językowych?
Model generuje najbardziej prawdopodobną kontynuację tekstu, a nie sprawdzony fakt. Oparcie odpowiedzi na pobranych źródłach zmniejsza ryzyko błędów, ale go nie eliminuje.
Czy istnieje polski LLM?
Tak, od lutego 2025 roku dostępna jest rządowa rodzina modeli PLLuM, a obok niej rozwija się otwarty model Bielik. Oba są trenowane z myślą o języku polskim.
LLM: powiązane pojęcia
Pojęcia, które warto znać razem z hasłem LLM.
- LLMs: What's a large language model? · Google for Developers
- Introduction to Large Language Models · Google for Developers
- Attention Is All You Need · arXiv (Vaswani et al.)
- Introducing ChatGPT · OpenAI
- Ministerstwo Cyfryzacji ogłasza PLLuM, rodzinę polskich modeli sztucznej inteligencji · iMagazine